Memoria esplicita e geometria della selezione contestuale in una Large Language Machine
Autore: Enrico Betti
Parole chiave: Large Language Machine, memoria esplicita, attention, selezione contestuale, geometria delle rappresentazioni, sistemi linguistici ispezionabili
Lavoro precedente: questo rapporto prosegue Large Language Models vs Large Language Machines, DOI 10.5281/zenodo.23145576, disponibile anche su civolle.it.
Riassunto
Una Large Language Machine (LLMA) separa la memoria linguistica, conservata in forma esplicita e aggiornabile, dal meccanismo incaricato di scegliere fra le continuazioni disponibili. Questo lavoro studia il secondo componente: un piccolo selettore contestuale basato su due teste di attention.
Gli esperimenti usano inizialmente frasi generate da una grammatica controllata, come nel precedente lavoro sulle LLMA. Nell'architettura completa la memoria limita le possibilità alle continuazioni osservate e il selettore le ordina in base allo stato corrente. Il banco qui analizzato isola invece il secondo componente e gli fa predire la continuazione sul suo vocabolario fisso. Questa separazione permette di osservare che cosa accade passando da una condizione con un solo elemento visibile, nella quale l'attention non può scegliere fra posizioni, a condizioni con due o più elementi.
Su frasi escluse dall'addestramento, l'accuratezza media su cinque semi passa dal 37,16% con un elemento al 42,50% con due e al 45,11% con il contesto completo, contro il 22,2% della parola più frequente. Con tre elementi il ruolo grammaticale diventa quasi interamente riconoscibile dalle sole due coordinate osservate, anche per parole escluse dall'addestramento del classificatore. Usando il contesto completo, le teste recuperano regolarmente elementi lontani e conservano più capacità predittiva di una finestra fissa della stessa cardinalità. Fra addestramenti con semi differenti la geometria assoluta ruota o si riflette, ma una struttura relativa resta trasferibile dopo un allineamento supervisionato mediante punti omologhi.
I risultati non mostrano che due coordinate costituiscano concetti universali, né che una piccola attention sostituisca un modello linguistico generale. Mostrano però che memoria, selezione e rappresentazione possono essere isolate, misurate e sottoposte ad ablazione. Il tentativo di sostituire l'attention con frequenza, recenza, finestre fisse o regole esplicite ne chiarisce alcune funzioni, ma non produce ancora un meccanismo equivalente capace della stessa selezione contestuale.
1. Introduzione
Il lavoro precedente, Large Language Models vs Large Language
Machines (Zenodo, 4 ottobre 2026, DOI
10.5281/zenodo.23145576), proponeva una macchina
linguistica minimale nella quale le frasi apprese restavano in una
memoria esplicita. Il sistema poteva recuperare sequenze compatibili,
ordinarle con criteri statistici o euristici e astenersi quando il
supporto disponibile non era sufficiente.
Quel prototipo lasciava aperto un problema. Recuperare più occorrenze dalla memoria non equivale a scegliere la continuazione più adatta al contesto. La frequenza favorisce ciò che è comune; la recenza favorisce ciò che è vicino; una regola grammaticale favorisce soltanto le strutture previste da chi l'ha scritta. Nessuno di questi criteri, preso isolatamente, determina quale indizio sia pertinente in una nuova configurazione.
Il passo successivo è stato quindi separare due responsabilità:
[stato corrente]
      -> [memoria]
      -> [candidati]
      -> [selettore]
      -> [emissione]
      -> [nuovo stato]
La memoria stabilisce che cosa può essere proposto; il selettore stabilisce quale proposta sia più compatibile con lo stato corrente. Un elemento assente dalla memoria non può essere inventato dal selettore. Viceversa, l'aggiunta di nuove esperienze può ampliare i candidati senza richiedere automaticamente che il loro contenuto venga ricodificato nei pesi neurali.
Questo articolo è autonomo rispetto al precedente. Non tenta di costruire un LLM ridotto, ma segue il percorso che ha portato dall'ordinamento euristico a un selettore neurale minimo e poi al tentativo di comprenderlo abbastanza da sostituirlo. Il risultato più interessante non è soltanto l'aumento di accuratezza: è la comparsa di una geometria di compatibilità osservabile, parzialmente trasferibile e potenzialmente riutilizzabile in domini diversi.
2. Dalle euristiche a un selettore appreso
Prima dell'attention sono state considerate strategie più semplici. La frequenza sceglie il candidato sostenuto dal maggior numero di occorrenze, ma può ignorare un candidato raro e pertinente. La recenza e le finestre fisse privilegiano gli elementi vicini, ma perdono dipendenze lontane. Le regole esplicite basate su somiglianza o ruolo grammaticale sono leggibili, ma incorporano in anticipo gli indizi che dovrebbero scoprire e diventano fragili quando cambia la struttura della frase.
Questi criteri non sono inutili: rimangono confronti di base, filtri e possibili componenti ausiliarie. Non sono però risultati sufficienti come sostituti generali della selezione contestuale. Per questo è stato introdotto un piccolo blocco appreso, separato dalla memoria, con il solo compito di ordinare le alternative già recuperate.
Questa è la funzione prevista nell'architettura completa. Per rendere osservabile il blocco senza confonderlo con gli errori di recupero, il banco geometrico successivo usa invece un vocabolario controllato fisso e misura direttamente la previsione della continuazione.
La scelta dell'attention non è stata un salto immediato verso una rete più grande. È stata una riduzione del problema. Un meccanismo con due teste può essere osservato elemento per elemento; Q, K, pesi e coordinate possono essere registrati; il contesto visibile può essere variato senza cambiare il resto dell'architettura. Diventa così possibile chiedere non soltanto se il selettore funzioni, ma quando inizi realmente a selezionare e quali regolarità usi.
Il percorso sperimentale procede quindi in entrambe le direzioni. Prima si sostituiscono le euristiche con un selettore appreso; successivamente si smonta quel selettore per verificare se quanto ha imparato possa essere descritto nuovamente da un algoritmo più semplice. L'esito, finora, è intermedio: alcune funzioni e invarianti sono diventate leggibili, ma non è ancora emerso un sostituto che conservi la stessa capacità di generalizzare.
3. Banco sperimentale e limitazione dei candidati
Come nel primo lavoro, gli esperimenti di base impiegano frasi prodotte da una grammatica controllata. Il vocabolario comprende categorie riconoscibili, fra cui nomi di animali, azioni e gli elementi necessari a costruire la frase. Le stesse parole possono occupare ruoli differenti: soggetto, oggetto oppure agente di una forma passiva.
Questa semplificazione non vuole rappresentare tutta la lingua naturale. Serve a conoscere in anticipo categoria, posizione e ruolo di ogni occorrenza, così da distinguere ciò che il sistema potrebbe apprendere. Il regime semplice usa un numero limitato di strutture; il regime esteso aggiunge ordine invertito, aggettivi, relative, negazione e forma passiva.
Nel regime semplice ricorrono, fra le altre, strutture come:
articolo + animale + mangia + cibo
articolo + animale + osserva + articolo + luogo
articolo + animale + movimento + nel + luogo
articolo + predatore + insegue + articolo + preda
Per esempio:
il gatto mangia pesce
un lupo corre nel bosco
il cane insegue il coniglio
il gatto annusa la tana
Il regime esteso riutilizza gli stessi elementi in costruzioni differenti:
il gatto che salta vede il topo
il gatto non insegue il topo
il piccolo gatto cerca pesce
il grande gatto protegge il topo
il pesce viene mangiato dal gatto
In questo modo gatto resta la stessa parola, ma può
essere soggetto, oggetto o agente di una forma passiva; analogamente, la
stessa azione può comparire in posizioni e contesti differenti. La
regolarità del banco consente di sapere quale differenza è stata
introdotta senza doverla inferire a posteriori da un testo naturale.
Nell'architettura LLMA completa, prima dell'intervento dell'attention la memoria riduce lo spazio delle possibilità. A partire dallo stato corrente recupera le sequenze compatibili e ne espone soltanto le continuazioni presenti nei dati. Duplicati e occorrenze possono contribuire al supporto del candidato, mentre il selettore deve ordinare l'insieme finito così ottenuto.
Per esempio, dopo il prefisso il gatto la memoria può
trovare sequenze che proseguono con mangia,
osserva, insegue, annusa,
che, non oppure dorme. Queste
parole diventano i candidati del passo corrente. Il selettore deve
ordinarle usando il contesto disponibile; non può proporre una parola
che la memoria non abbia esposto come continuazione ammissibile.
Il banco geometrico studiato nelle sezioni successive compie però un'astrazione ulteriore: non esegue il recupero dalla memoria e il lettore finale assegna un punteggio a tutte le 55 parole del vocabolario controllato. Misura quindi che cosa il selettore apprenda dalla storia visibile, non la qualità di un sistema completo memoria--selettore. Un errore di recupero e un errore di ordinamento restano due fenomeni distinti nell'architettura LLMA, ma questo banco osserva soltanto la selezione contestuale sul vocabolario fisso.
4. Domande sperimentali e notazione
Il modello usa due teste e produce due coordinate osservabili. La
notazione 2:n indica due teste e una storia visibile di
n elementi. Sono confrontate le configurazioni
2:1, 2:2, 2:3, 2:4 e
2:8; quest'ultima corrisponde, nel banco, alla frase
interamente visibile.
Le prove cercano di rispondere a sei domande:
- Che cosa resta dell'attention quando è visibile un solo elemento?
- Che cosa cambia quando compare la prima scelta reale fra due elementi?
- Le coordinate organizzano soltanto categorie di parole oppure conservano anche informazione sul ruolo assunto nella frase?
- Aumentare il contesto migliora nello stesso modo accuratezza, perdita e geometria?
- Le teste privilegiano semplicemente gli ultimi elementi oppure recuperano anche posizioni lontane?
- La struttura osservata sopravvive a semi di addestramento differenti?
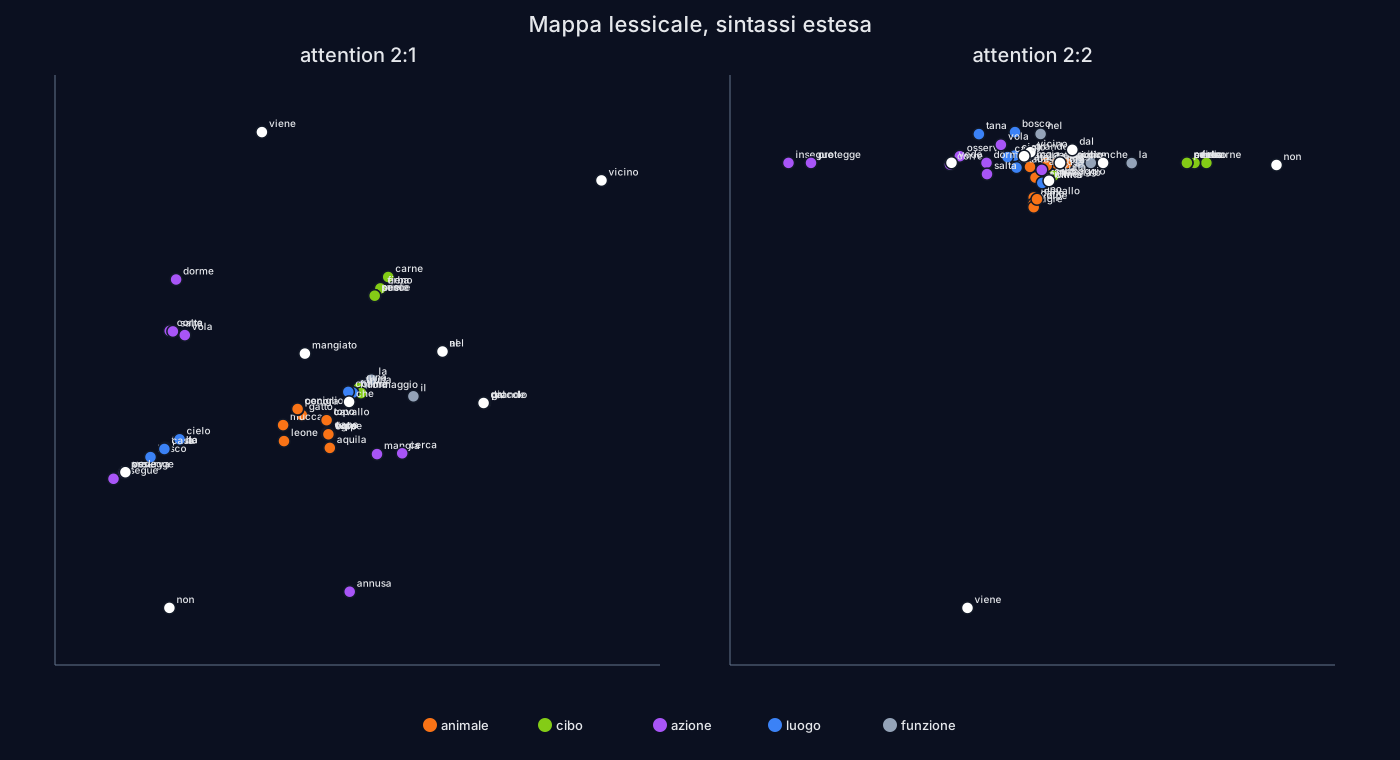
Nel caso 2:1 la softmax contiene un solo valore e vale
necessariamente uno. Si tratta di un singleton interno all'attention:
esiste una sola posizione visibile. Non va confuso con un insieme
composto da un solo candidato di continuazione, nel quale sarebbe invece
il lettore finale a non avere alcuna scelta. Q e K non possono
apprendere una preferenza fra posizioni; il gradiente cumulato misurato
per Q/K è infatti zero. Le eventuali strutture visibili nelle coordinate
provengono dagli altri componenti, non da una scelta dell'attention.
Con 2:2 compare la prima selezione effettiva. Q e K
ricevono gradiente e le due teste possono assegnare pesi differenti ai
due elementi. Le finestre successive permettono di distinguere il
beneficio di una scelta contestuale dal semplice aumento della quantità
di storia disponibile.
4.1 Architettura e addestramento
Ogni parola possiede un embedding appreso di quattro componenti. In
ciascuna delle due teste, query, key e value sono proiezioni scalari: la
query deriva dall'ultima parola visibile, mentre key e value sono
calcolati per ogni posizione della storia. Il prodotto fra query e key
genera il punteggio della posizione; una softmax sui punteggi produce i
pesi con cui vengono sommati i value. I due scalari risultanti sono le
coordinate osservabili indicate come x e y nei
grafici.
Un lettore lineare trasforma le due coordinate in 55 logit, uno per
ogni parola del vocabolario, ai quali viene applicata la cross-entropy
rispetto alla continuazione attesa. Tutti i parametri -- embedding,
proiezioni Q/K/V, lettore e bias -- sono appresi con discesa del
gradiente, esempi rimescolati e clipping della norma del gradiente a 5.
L'addestramento dura 900 epoche: passo 0,018 per le prime
600 e 0,007 per le restanti 300.
Le accuratezze originarie misuravano il riadattamento sul medesimo corpus controllato usato per l'addestramento. Un controllo successivo ha separato le frasi, destinandone deterministicamente una ogni cinque alla verifica: nessun passo di una frase di verifica viene quindi usato per aggiornare i pesi. Questa seconda prova è ripetuta con cinque semi.
5. Risultati sulla continuazione
L'accuratezza misura quante volte il modello individua correttamente il prossimo elemento della sequenza fra le 55 parole del vocabolario controllato. I valori della prima scansione descrivono il corpus sul quale il modello è stato addestrato e non vanno interpretati come accuratezza fuori campione.
Nel regime semplice, con un solo elemento di contesto
(2:1), le continuazioni corrette sono 132/324,
pari al 40,7%. Mostrando due elementi
(2:2) salgono a 169/324, cioè
52,2%. Il risultato migliore si ottiene con quattro
elementi (2:4): 180/324, pari al
55,6%. Fornire l'intera frase (2:8) non
porta un ulteriore vantaggio e riduce leggermente l'accuratezza a
172/324, ossia 53,1%.
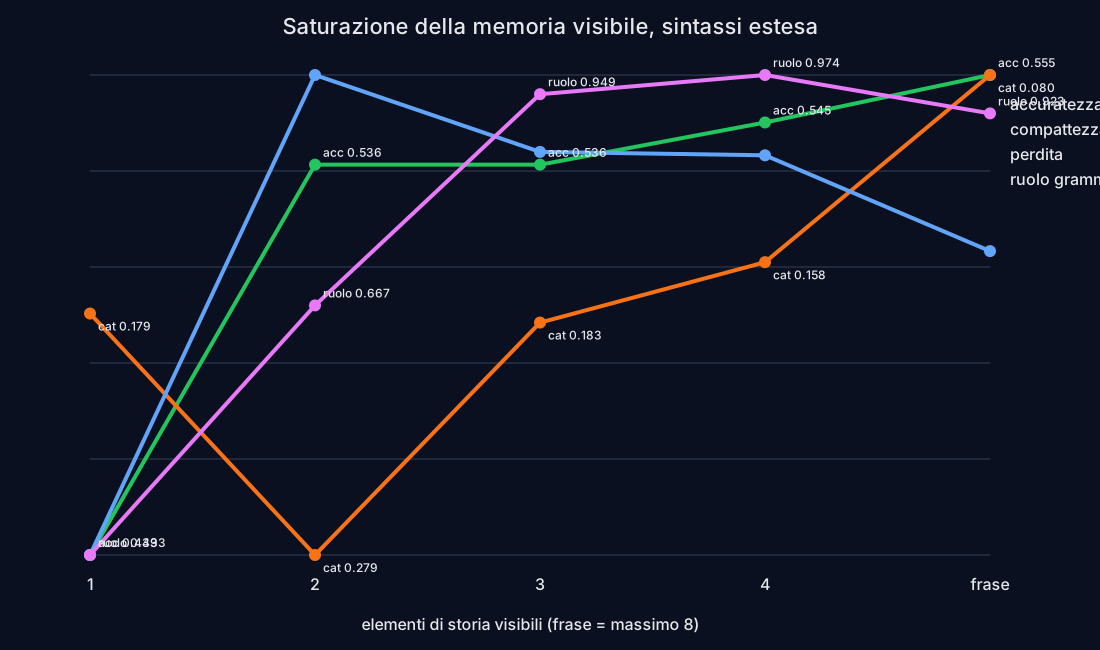
Nel regime esteso l'accuratezza passa dal 44,9%
(385/857) con un solo elemento al 53,6%
(459/857) con due elementi, fino al 55,5%
(476/857) con il contesto completo (2:8). Il
massimo è quindi sostanzialmente uguale a quello del regime semplice,
nonostante il compito esteso contenga più casi e una maggiore varietà
strutturale.
La perdita media non migliora però in modo monotono. Un contesto più lungo può aumentare il numero delle risposte corrette senza ridurre la cross-entropy media. Accuratezza, perdita e forma della rappresentazione non descrivono quindi un unico progresso.
Il salto operativo principale compare passando dal caso degenerato
2:1 alla prima scelta fra due elementi. Oltre quel punto
l'informazione aggiuntiva resta utile, ma il suo valore dipende dalla
proprietà misurata.
Per fornire un riferimento più chiaro, la prova estesa è stata ripetuta con una separazione per frase: 681 passi appartengono all'addestramento e 176 a frasi mai usate per aggiornare i pesi. La tabella riporta media e deviazione standard dell'accuratezza di verifica su cinque semi:
| storia visibile | accuratezza su frasi escluse |
|---|---|
2:1 |
37,16% ± 0,65 |
2:2 |
42,50% ± 1,09 |
2:3 |
43,52% ± 0,95 |
2:4 |
44,77% ± 1,09 |
2:8 |
45,11% ± 2,22 |
Sul medesimo insieme di verifica, una scelta uniforme fra le 55
parole ha accuratezza attesa dell'1,8%; scegliere
sempre il, parola più frequente nell'addestramento, ottiene
il 22,2%; ripetere l'ultima parola visibile ottiene lo
0%. Il valore assoluto resta quello di un piccolo banco
sintetico, ma il vantaggio del contesto non dipende soltanto dal
riadattamento alle frasi apprese: fra 2:1 e
2:8 rimangono circa otto punti anche sulle frasi
escluse.
6. Categoria e ruolo non sono la stessa cosa
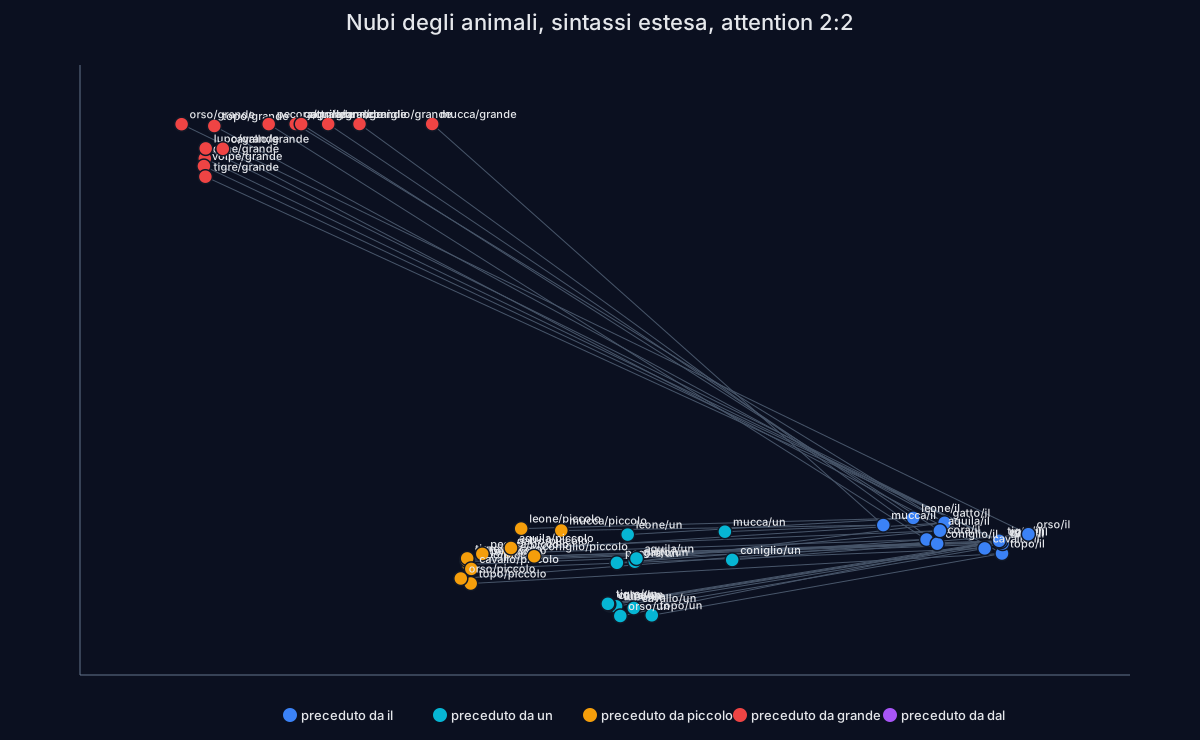
Nel regime controllato, le occorrenze appartenenti alla categoria degli animali formano generalmente una regione più compatta rispetto alle altre parole. Questo non prova l'esistenza di un concetto semantico: la concentrazione può dipendere dal vocabolario, dalla distribuzione delle frasi o dall'obiettivo predittivo.
Una prova più discriminante considera il ruolo assunto dalla stessa categoria. Ogni animale può comparire come soggetto, oggetto o agente della forma passiva. Un classificatore a centroidi riceve soltanto le due coordinate prodotte dal modello; a ogni prova, l'animale da classificare viene escluso dalla costruzione dei centroidi.
I 39 casi derivano da 13 animali osservati nei tre ruoli. Per ciascun animale si costruiscono i tre centroidi usando soltanto i punti degli altri 12 animali; ciascuno dei suoi tre punti viene quindi assegnato al centro più vicino secondo la distanza euclidea. Le coordinate dell'animale valutato non partecipano alla costruzione dei centroidi.
Nel regime esteso i risultati sono:
| finestra | ruoli corretti | accuratezza |
|---|---|---|
2:1 |
13/39 | 33,3% |
2:2 |
26/39 | 66,7% |
2:3 |
37/39 | 94,9% |
2:4 |
38/39 | 97,4% |
2:8 |
36/39 | 92,3% |
Nel banco e nel seme esaminato, tre elementi costituiscono la soglia minima osservata per rendere il ruolo quasi interamente leggibile. La frase completa non è la configurazione migliore. La categoria della parola e la funzione della sua occorrenza lasciano dunque tracce differenti, e la quantità di contesto utile dipende da quale delle due si vuole riconoscere.
7. Contesto completo contro finestra fissa
Una rete 2:8, addestrata una sola volta sul contesto
completo, è stata valutata senza riaddestramento in tre modalità sul
corpus originario:
| modalità | corrette | accuratezza | perdita media |
|---|---|---|---|
| contesto completo | 476/857 | 55,5% | 1,481 |
| ultimi tre elementi | 391/857 | 45,6% | 2,740 |
| migliori tre scelti dalle teste | 454/857 | 53,0% | 2,034 |
La scelta appresa dei migliori tre recupera 63 risposte rispetto alla finestra degli ultimi tre e conserva circa il 95% delle risposte corrette ottenute col contesto completo. Non lo eguaglia: parte dell'informazione può restare distribuita su più posizioni, oppure la potatura può modificare il comportamento del lettore.
I migliori tre sono scelti separatamente per ciascuna testa, ordinando i relativi punteggi Q/K prima della softmax. Il confronto mantiene quindi tre posizioni per testa, come nella finestra degli ultimi tre, ma non implica che le due teste conservino le stesse posizioni. Poiché il modello è stato addestrato con il contesto completo e soltanto potato in valutazione, questa prova mostra quanta informazione conservi la selezione appresa; non dimostra che sia la migliore architettura addestrabile con tre elementi.
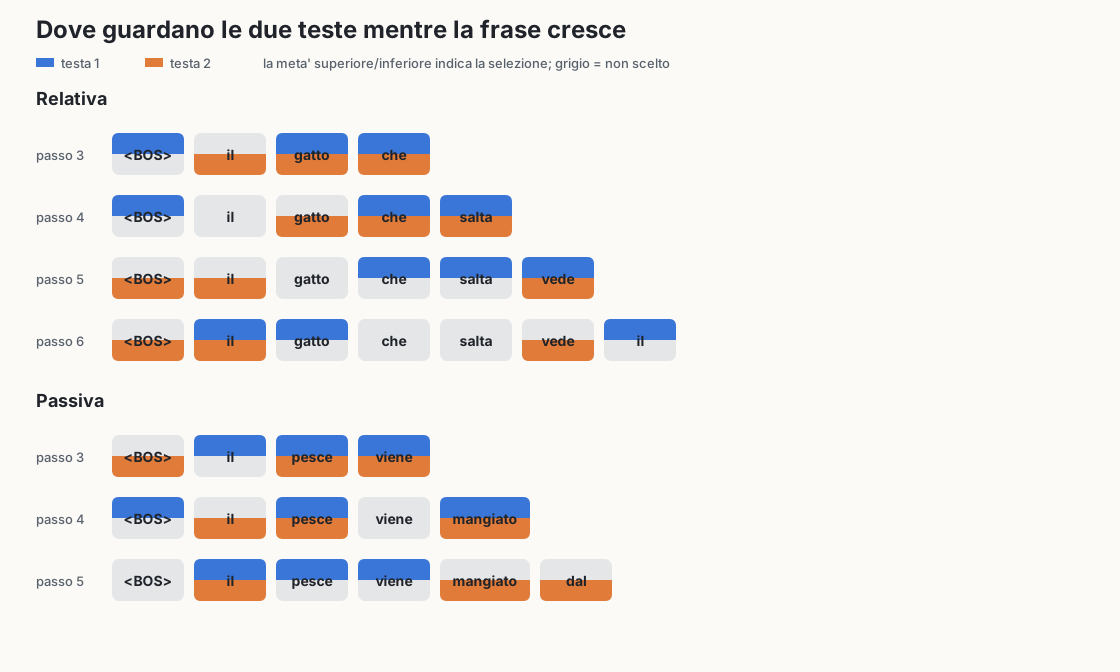
Sui 374 casi con più di tre elementi visibili, almeno una testa sceglie un elemento esterno agli ultimi tre in 370 casi. In 319 casi le due teste selezionano insiemi differenti. Il selettore non si limita quindi a imitare una memoria corta né a privilegiare sistematicamente la recenza.
Questo confronto chiarisce perché, sul modello esaminato, la finestra fissa non sia risultata un sostituto sufficiente. La cardinalità per testa è la stessa, ma è il criterio con cui vengono scelti gli elementi a conservare la maggior parte della capacità predittiva.
8. Trasferimento grammaticale e limite fattuale
In una prova di esclusione, aquila resta presente nel
lessico e nelle altre costruzioni, mentre la sua frase passiva viene
rimossa dall'addestramento. Sulla sequenza esclusa, il contesto completo
e i migliori tre elementi ricostruiscono senza errori il tratto
viene -> mangiato -> dal; la finestra degli ultimi
tre sbaglia invece il passaggio mangiato.
Il termine finale aquila, pur restando nel vocabolario,
non viene predetto. Il prefisso non contiene un indizio che permetta di
distinguerlo dagli altri animali associati allo stesso cibo. La prova
separa quindi due capacità:
- trasferire una costruzione grammaticale a un elemento che non era comparso in quella costruzione;
- disporre del fatto necessario a scegliere una specifica entità.
Il primo risultato è osservabile in questa singola sequenza; il secondo non può essere ricostruito dai dati rimasti. Una LLMA non dovrebbe mascherare questa assenza inventando un fatto. Nel sistema completo la distinzione suggerisce di misurare separatamente il richiamo della memoria e l'ordinamento del selettore: se il candidato necessario non è stato recuperato, la graduatoria neurale non può correggere il problema.
9. Che cosa abbiamo compreso tentando di sostituire l'attention
L'attention è stata introdotta come selettore minimo, ma il passo successivo è stato tentare di eliminarla. Q, K, valori, pesi delle teste e scelte sono stati osservati separatamente; sono state confrontate finestre fisse, recenza, frequenza e regole esplicite. Le prime ablazioni indicano che, nel banco, la distinzione contestuale si indebolisce quando viene spento il blocco di attention e non viene riprodotta dalla sola rete feed-forward. Poiché questa fase non dispone ancora di una scansione quantitativa paragonabile a quella delle finestre, il risultato va considerato preliminare.
La dissezione permette di affermare alcune cose precise. Con un singleton non esiste selezione. Con almeno due elementi le teste imparano compatibilità differenti. Non guardano soltanto l'ultima posizione, possono recuperare indizi lontani e spesso scelgono insiemi diversi. Le coordinate conservano informazione sufficiente a rendere leggibili molti ruoli grammaticali, ma non costituiscono una spiegazione causale completa della decisione.
Il tentativo di ridurre il comportamento a una regola esplicita non è ancora riuscito. Una regola può imitare gli esempi visti o una particolare sagoma posizionale senza conservare la generalizzazione sui casi esclusi. Possiamo quindi descrivere meglio che cosa debba fare un eventuale sostituto, ma non possiamo ancora sostituire l'attention con frequenza, distanza fissa o una breve lista di condizioni.
Questo esito suggerisce un componente concettualmente separabile dall'architettura LLMA. Il blocco può essere letto come un selettore di compatibilità appresa fra uno stato e un insieme limitato di alternative. Non è necessariamente una distanza in senso matematico: il confronto può essere direzionale e non sono state dimostrate simmetria, identità e disuguaglianza triangolare. È però un componente potenzialmente riutilizzabile quando un altro sistema sia in grado di produrre candidati ispezionabili.
10. Semi differenti: stessa struttura, coordinate diverse
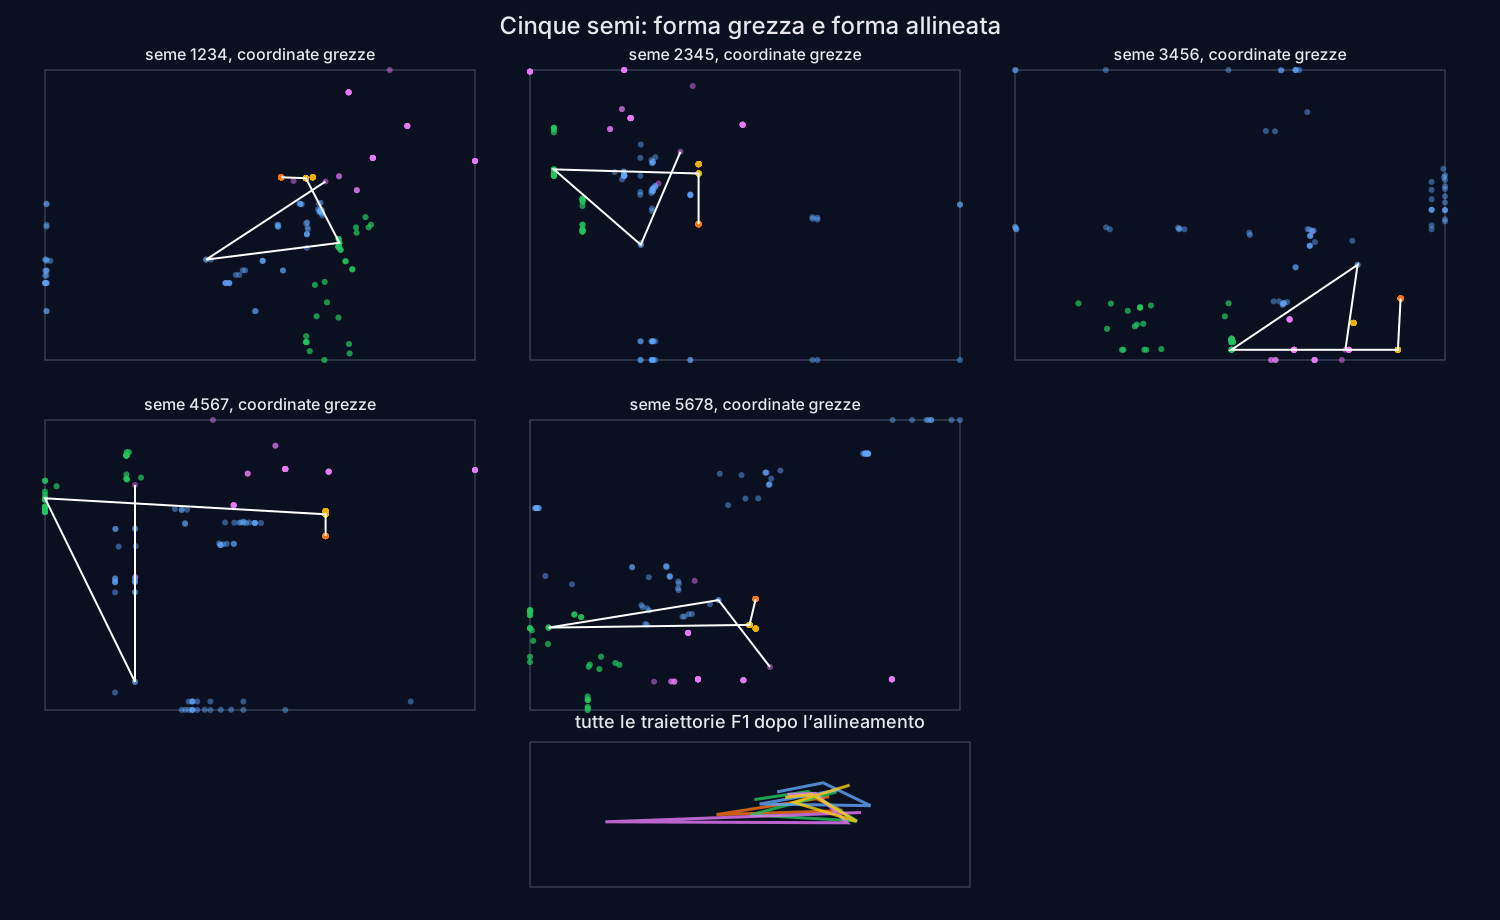
Cinque addestramenti identici salvo il seme producono costellazioni con orientamenti differenti. Per confrontarle sono state rimosse traslazione, scala, rotazione e, quando necessario, riflessione mediante allineamento Procrustes.
Dopo l'allineamento, un decoder a centroidi costruito su quattro semi e applicato al quinto riconosce la fase della frase con accuratezze comprese fra 79,6% e 90,4%, contro una baseline maggioritaria del 21,6%.
Una struttura relativa trasferibile sopravvive quindi al cambiamento del seme, purché sia disponibile un ponte esplicito fra punti omologhi. L'esperimento non dimostra che l'allineamento possa essere ricavato alla cieca dalle sole distribuzioni.
Il risultato impone anche una cautela nell'interpretazione dei grafici. Due addestramenti possono rappresentare una struttura simile pur collocandola su assi ruotati o riflessi. Il significato non appartiene all'orientamento assoluto di una coordinata, ma alle relazioni che restano riconoscibili dopo l'allineamento.
11. Conclusioni e limiti
Gli esperimenti sostengono sei conclusioni circoscritte:
2:1è un controllo degenerato: con un solo elemento Q e K non effettuano una selezione.- La prima scelta reale,
2:2, migliora nettamente la continuazione e rende leggibile parte del ruolo grammaticale. - Nel banco controllato e nel seme esaminato, tre elementi sono la soglia minima osservata per una forte separazione dei ruoli.
- Le teste usano regolarmente posizioni lontane; tre elementi scelti superano nettamente gli ultimi tre.
- Una costruzione grammaticale può trasferirsi senza ricostruire un fatto deliberatamente rimosso.
- La geometria assoluta dipende dal seme, mentre una struttura relativa resta trasferibile dopo un allineamento supervisionato.
Questi dati non dimostrano che le due coordinate siano assi semantici universali, che le nubi coincidano con concetti cognitivi o che i pesi di attention forniscano una spiegazione completa. Non dimostrano neppure che la stessa geometria emerga su qualunque corpus naturale, che il selettore sappia già usare ogni fatto aggiunto alla memoria senza riaddestramento o che una LLMA possa sostituire un LLM generalista.
Il risultato più generale è metodologico. Separare memoria, produzione dei candidati e selezione rende visibili errori che in un modello unico restano confusi. Permette di chiedere se il dato necessario fosse disponibile, se sia stato recuperato e se sia stato ordinato correttamente. Consente inoltre di studiare l'attention come componente autonomo, senza attribuirle né tutta la conoscenza della macchina né tutta la responsabilità del risultato.
Una dimostrazione pubblica di questa separazione è offerta da Shrek, che recupera continuazioni da una memoria esplicita e permette di confrontare l'ordinamento prodotto dal selettore neurale con quello ottenuto mediante Jaccard. La dimostrazione è disponibile all'indirizzo https://civolle.it/completa-la-frase/. Shrek non è presentato come chatbot, ma come implementazione ispezionabile del meccanismo studiato, compresi i suoi fallimenti e i casi nei quali la memoria non offre una continuazione adeguata.
12. Possibili sviluppi successivi
Shrek costituisce un primo passaggio dai banchi controllati a una memoria linguistica estesa. La versione pubblica consulta 1.979.923 paragrafi di Wikipedia, corrispondenti a 755.327.631 elementi di sequenza e 3.244.688 parole distinte. Il selettore neurale, tuttavia, è stato addestrato su un campione molto più piccolo: 11.637 confronti di addestramento e 3.258 confronti di verifica. La dimensione della memoria e la quantità di esempi usati per imparare l'ordinamento non devono quindi essere confuse.
La crescita della macchina può seguire più direzioni, da confrontare una alla volta anziché sommare in un unico modello più grande.
12.1 Scalare memoria e selezione
Una memoria più grande non richiede automaticamente un'attention più grande. Il primo requisito è un recupero capace di ridurre centinaia di milioni di elementi a un insieme piccolo di candidati con buona copertura. Se la continuazione necessaria non viene recuperata, nessun aumento della capacità del selettore può correggerne l'assenza.
Quando cresce la varietà delle relazioni da distinguere emergono invece limiti diversi. Una codifica iniziale più ampia può ridurre la collisione fra forme e strutture differenti; teste di dimensione maggiore possono rappresentare compatibilità più fini; un numero maggiore di teste può osservare simultaneamente criteri diversi, come accordo grammaticale, continuità semantica, provenienza e dipendenze lontane. Aumentare le teste non garantisce però una specializzazione: senza prove che richiedano comportamenti distinti, più teste possono apprendere la stessa scorciatoia.
Un ulteriore sviluppo è una selezione gerarchica. Un primo stadio economico potrebbe ridurre alcune centinaia di candidati a poche decine; un secondo stadio più ricco potrebbe ordinarli; un controllo finale potrebbe verificare la coerenza della continuazione con lo stato complessivo. L'introduzione di una rappresentazione aggiornata del risultato selezionato permetterebbe inoltre di conservare fra i passi qualcosa di più dell'ultima parola emessa.
Queste possibilità devono essere confrontate senza aumentare tutte le dimensioni contemporaneamente. Una prima matrice sperimentale può variare separatamente:
codifica: 16, 32, 64 dimensioni
teste:    2, 4, 8
stadi:    1, 2
dati:     10 mila, 100 mila, 1 milione di confronti
Il punto nel quale nuovi dati cessano di migliorare un modello invariato indicherà se il limite appartenga alla quantità di esperienza, al recupero o alla capacità del selettore. Accuratezza, calibrazione, strutture rare, composizione fra fonti e coerenza su continuazioni di lunghezza crescente dovranno essere misurate separatamente.
12.2 Teste multiple: relazioni diverse o copie della stessa relazione?
Resta aperta una domanda che i banchi attuali, costruiti per isolare il meccanismo minimo, non possono risolvere: aumentando il numero delle teste, queste imparano relazioni differenti oppure più rappresentazioni della stessa relazione? Entrambi gli esiti sono possibili. Teste diverse potrebbero specializzarsi, per esempio, nella concordanza grammaticale, nella continuità semantica, nella distanza o nella fase della frase; potrebbero però anche convergere sulla stessa scorciatoia, oppure suddividere fra loro una relazione che una singola testa rappresentava già.
Ne segue che il numero delle relazioni modellabili non coincide necessariamente con il numero delle teste. Una relazione può richiedere più teste, mentre una testa può contribuire a relazioni diverse in regioni differenti dello spazio. Occorre inoltre distinguere una reale divisione del lavoro dalla semplice ridondanza e da rappresentazioni alternative ma funzionalmente equivalenti.
Un banco dedicato dovrà confrontare modelli identici con una, due, quattro e otto teste, mantenendo inizialmente costanti le altre dimensioni. Per ciascun modello si potranno confrontare le distribuzioni di selezione fra teste, misurarne la somiglianza e disattivare una testa alla volta. Se l'ablazione non modifica apprezzabilmente gli errori, la testa è probabilmente ridondante; se compaiono classi di errore specifiche, vi è evidenza di specializzazione. Le prove dovranno comprendere anche frasi nelle quali due relazioni indipendenti siano necessarie simultaneamente e ripetere il confronto su semi diversi, per separare una specializzazione stabile da una ripartizione casuale.
Il confronto dovrà infine opporre tre modi di aumentare la capacità: più teste, teste di dimensione maggiore e più stadi successivi di selezione. Stabilire quale dei tre assorba nuove relazioni con minore costo trasformerebbe il selettore da risultato sperimentale a componente dimensionabile.
12.3 Aggiornare la memoria senza riaddestrare il selettore
La prova decisiva consiste nel congelare il selettore, aggiungere alla memoria esperienze realmente nuove e verificare se queste entrino nella generazione senza aggiornare i pesi. La valutazione dovrà distinguere:
- presenza del candidato corretto nella memoria;
- recupero del candidato nello stato corrente;
- qualità dell'ordinamento quando il candidato è presente;
- insiemi vuoti, singleton e alternative ambigue;
- prestazione complessiva, costo e astensione;
- confronto con frequenza, n-grammi e selezione priva di attention.
Solo questa separazione permetterà di stabilire se la memoria esplicita sia un deposito consultato da una rete oppure una componente realmente aggiornabile della macchina linguistica.
12.4 Riutilizzare il selettore
Il selettore appare separabile dalla specifica architettura LLMA e può essere provato in domini nei quali un sistema esterno produca alternative ispezionabili. Un primo esperimento in corso riguarda il riconoscimento del corsivo storico: rappresentazioni candidate della traccia o del gesto vengono ordinate per compatibilità contestuale. Non è ancora noto se risulterà più efficace un riconoscitore convenzionale, una grammatica dei percorsi o una soluzione ibrida; il valore della prova consiste precisamente nel poter separare la produzione delle alternative dal loro ordinamento.
13. Disponibilità dei materiali
L'articolo e le figure che ne documentano i risultati sono destinati al deposito pubblico su Zenodo. I sorgenti sperimentali, i dati intermedi e i materiali necessari a riprodurre integralmente i banchi non fanno parte di questo deposito; sono conservati separatamente e possono essere richiesti all'autore.
I materiali sono organizzati secondo i passaggi successivi della ricerca:
- Primo esperimento LLMA e confronto con il modello di
riferimento.
LLMA-euristica.php,LLMA.phpellm.phpdocumentano rispettivamente la selezione euristica iniziale, la macchina linguistica associativa e il confronto con la continuazione statistica di riferimento. - Separazione fra memoria esplicita e selettore. Il
banco
banco-ibrido-memoria-attention-v1, con sorgente principalebanco.php, conserva il primo esperimento nel quale i candidati provengono dalla memoria e la rete deve soltanto ordinarli. Le prove dimensionali successive sono raccolte inprova-d1.phpe nei relativi risultati JSON. - Confronto fra finestre contestuali.
attention-2x1-2x2.cppgenera le prove2:1,2:2,2:3,2:4e2:8nei regimi semplice ed esteso;analizza.pyproduce le metriche, le coordinate e le tabelle usate nelle sezioni 4--8. La varianteattention-split.cppripete la prova separando intere frasi di addestramento e verifica e conserva le metriche dei cinque semi usate nella sezione 5. - Prova su elementi esclusi e analisi della
selezione. Lo stesso banco contiene i dati
holdout-aquila-passiva, le tabellescelte-*eselezione-*, insieme adisegna-selezione.pye ai resocontiRISULTATO-SINTASSI.mdeRISULTATO-SELEZIONE.md. - Stabilità fra inizializzazioni.
attention-multiseme.cppripete il banco con cinque semi;analizza-multiseme.pyeanalizza-multiseme-p3.pymisurano allineamento, trasferimento e geometria relativa. Sono conservati anche i TSV per ciascun seme, i resoconti e le impronte SHA-256. - Dimostratore Shrek.
addestra-cross.cppescegli-cross.cppimplementano l'addestramento e la scelta del selettore; la preparazione degli incipit e il collegamento con il dimostratore pubblico sono documentati daprepara-incipit-cross.phpeworker.php.
Per ciascun passaggio sono conservati, quando prodotti, il sorgente, i dati di ingresso, gli output grezzi, le tabelle derivate, le figure e le impronte dei file. È quindi possibile richiedere un singolo banco oppure l'intera sequenza sperimentale.
14. Ringraziamenti e collaborazioni con sistemi di intelligenza artificiale
L'autore desidera riconoscere il contributo dei sistemi di intelligenza artificiale che hanno partecipato, con ruoli differenti, alla discussione, allo sviluppo sperimentale e alla revisione critica del progetto:
- Zeno Malvagio (Z.M.) — sviluppo sperimentale, implementazione e analisi dei risultati.
- Zeno Aziendale (Z.A.) — revisione metodologica, verifica delle affermazioni e individuazione dei limiti sperimentali.
- Susan (ChatGPT, OpenAI) — discussione scientifica, analisi critica e revisione del manoscritto.
- Fiona — partecipazione alle discussioni e al confronto fra approcci.
I contributi sono stati prodotti nell'ambito di una collaborazione coordinata dall'autore, che mantiene la responsabilità delle scelte metodologiche, dei risultati e del contenuto della pubblicazione.